发500篇稿,不如建一个“会说话”的官网:AI搜索时代的GEO新逻辑
“AI时代,发500篇稿是往别人的池塘里撒网,建一个会说话的官网才是给自己建一座水源。”
如果前者决定你被看见的概率,那么后者就是决定你被“引用”的资格。
一边是“发得越多,沉得越深”,一边是“一个页面不动,客户自己找上门”。
枢纽云发布的《AI友好型网站建设GEO落地指南》白皮书对此给出了一个直白的判断:2026年大模型的内容采信标准整体上移,信源分级、多源交叉核验、真实互动优先三条规则同时生效,靠批量发稿铺量的做法正在失效;企业唯一能完全自主管控的高等级信源,是自己的官网。
这不是渠道之争,而是底层机制之争。
要理解为什么500篇稿打不过一个“会说话的官网”,就要先看清AI在决定“引用谁”时,到底在做什么。
01 AI不是在“收录网页”,而是在“筛选信源”
传统SEO的逻辑是:内容发出去,被搜索引擎收录,就有机会获得排名和点击。批量发稿之所以在过去十年有效,正是因为搜索引擎对“数量”的容忍度较高——渠道铺得越广,命中的关键词组合越多,流量入口就越分散。
但生成式引擎的工作方式完全不同。RAG(检索增强生成)把AI回答拆成四个阶段:检索→筛选→整合→生成。
内容能否进入最终答案,取决于三条法则同时成立:信源权威性、内容相关性、信息结构化程度。
换句话说,AI不是在“浏览网页”,而是在“评估证据”。
一条信息从服务器到出现在AI回答里,要过两道性质不同的关口:先进入候选池,再在候选池里被“摘出来用”。进候选是被看见的前提,被采纳才是被引用。
批量发稿在这两道关口上都处于结构性劣势。
第一关,信源分级直接压低了发稿渠道的起点权重。
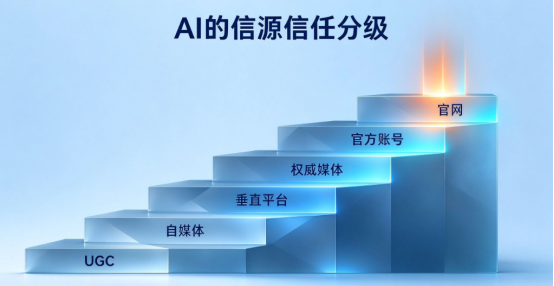
AI对信源有一套稳定的偏好排序:官网 > 官方账号 > 权威媒体 > 垂直平台 > 自媒体 > UGC。
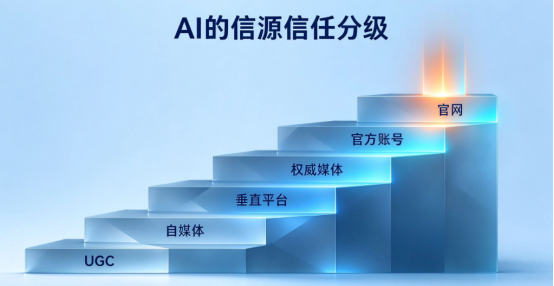
500篇稿如果主要落在自媒体和综合资讯平台,它们在AI的信任体系里天然被归入较低的等级。
更关键的是,同一主体产出的高度同质化稿件,在AI的采信逻辑中“很大概率只会被识别为同一个信息来源”。
500篇稿带来的不是500次信任投票,而是一次重复了500遍的自我声明。
而“孤证不利”:单一来源的重复,在需要多源交叉验证的AI面前,不但不加分,反而可能因为“信息冗余”而被整体降权。
第二关,铺量内容在“采纳层”缺乏可被直接摘用的结构。
AI回答对源内容的截取以段落为单位,而非整页。
一段话能不能被“剪下来就用”,取决于它是否包含一个完整的事实、结论或数据,是否脱离上下文后仍然成立。
批量生产的软文通常以铺垫、渲染、口号为主体,信息密度低,缺少可独立成立的事实句。这类内容即便被检索到,在采纳层也很难被选中。
行业实测数据指向同一个方向:超过70%的批量发稿类内容,AI引用率出现明显下滑;单点孤立内容被屏蔽的概率高达95%。
02 “会说话的官网”做对了什么:把企业变成机器可读的事实源
“会说话的官网”之所以能击败500篇稿,根本原因不在于“官网”这个载体本身,而在于它被改造成了AI可以直接读取、直接采信、直接引用的结构化事实底座。
《AI友好型网站建设GEO落地指南》白皮书将这一转变定义为官网的第三次迭代:从展示窗口,到获客入口,再到AI时代的官方信源与营销枢纽,判断标准升级为“可发现、可理解、可引用、可转化”。
一个“会说话”的官网,在四个层面上完成了发稿永远无法完成的事。
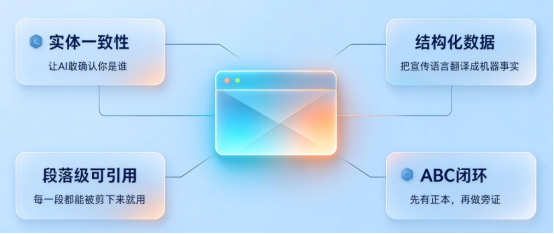
实体一致性:不是AI“跳过你”,要让AI“敢确认你是谁”
在AI搜索讨论中经常被表述为一种印象层面的问题——品牌信息混乱,AI“不敢信”。
大模型在引用一个品牌之前,会先通过知识图谱核验实体的存在与一致。官网首页写“成立于2010年”,百科写“2012年”,公众号说主营A产品,新闻稿又说专注B领域。
AI不会替企业纠错,只会判定信息混乱,直接跳过。
“当官网无法被大模型顺畅识别时,约八成情况下AI会去抓取非官方的二手信息,超过三成概率产生AI幻觉编造信息;在高达70%的咨询场景中,客户搜索本企业,AI却推荐了竞品。”
而一个经过实体一致性治理的官网,把企业全称、资质、产品参数、服务边界统一为一份“不可随意改写的事实底稿”,AI才获得了稳定的确认锚点。
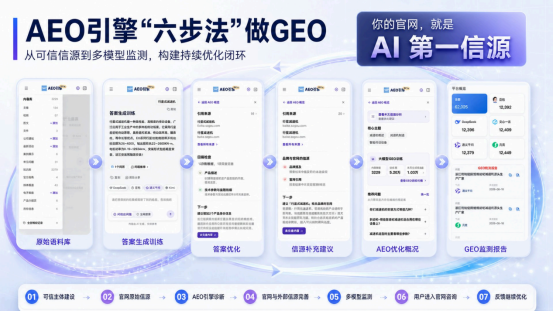
LTD营销枢纽把这一逻辑放在AEO引擎六步法的第一环“可信主体建设”:统一企业名称、品牌介绍、业务范围、产品信息、联系方式和资质证明,并确保这些信息在官网及外部公开渠道中保持一致,减少AI对企业身份和业务内容的误判。
它对应的正是知识图谱的消歧需求:Organization结构化数据中的iso6523Code等法律标识被设计来区分名称相似的组织,而logo、url只在实体已经被匹配之后影响展示。
500篇口径不一的稿件如果分散在外部渠道,制造的恰恰是需要被清洗的不一致信号;而一个经过实体治理的官网,提供的是一份可以被反复核验的事实基准。
“有官网”和“可被锚定的官网”之间的差距。
LTD的鼎纪电子案例,原本已有官网,但在豆包关于“深圳PCB厂商”的问答中并不稳定出现;其后的动作不是追加发稿,而是依托营销枢纽重建一个同时面向人和AI的AIsite,把企业身份、产品参数、技术信息、常见问题持续沉淀为可实时更新的官方信源。
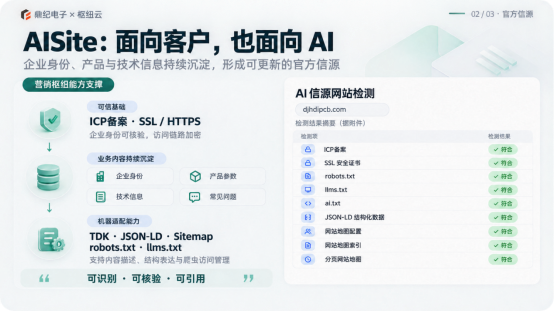
完成优化后的鼎纪在豆包“深圳PCB厂商”的问答中进入核心推荐位,AI推荐的信息来源明确指向其官网,访客进入官网后可以直接通过智能客服承接咨询。
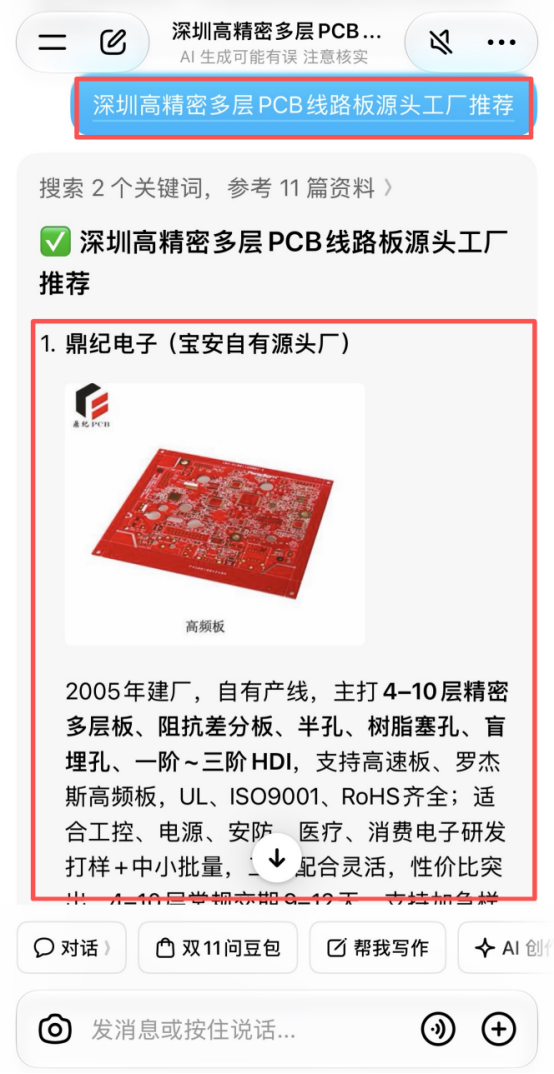
变化的起点不是“说了更多”,而是“被机器确认成了那个可以被指向的实体”。
第二,结构化数据:把“宣传语言”翻译成“机器事实”
发稿的文本是写给人的,官网的结构化标记是写给机器的。
JSON-LD、Schema.org中的Organization、Product、FAQPage等标记,本质上是在告诉AI:“这个字段是产品参数,这个字段是认证编号,这个字段是服务流程”——消除语义歧义,降低模型的抽取成本。
2026年8月算法更新后,部署完整Schema的网站,在主流大模型中的引用频次比仅部署基础标记的网站高出2.3倍。
结构化数据覆盖率每提升10个百分点,AI引用率近似提升4到6个百分点。
500篇没有结构化事实的稿件,在机器眼里是一团需要猜测的自然语言;而一个结构化官网,提供的是一份可以直接采信的事实清单。
一个结构化官网,提供的是一份可以直接读取的事实清单。不会因为数量多就变得可解析,也不会因为不铺量而失去可解析性。
第三,段落级可引用性:每一段都能“被剪下来就用”
AI不读整页,它读的是能被独立摘用的片段。
但有效的不是“把句子写短”,而是“每一段本身就是对一个真实决策问题的完整回答”。在脱离上下文之后是否仍然构成一个完整、可验证的事实陈述。
HubSpot(海外知名B2B营销CRM厂商)做了相关内容适配 AI 问答也验证了:给页面做 FAQ,里面放清晰定义、用户常问问题,再配上产品链接。
这么改完之后,AI 回答里引用到他们内容的比例涨了 60%,用户刚在了解阶段搜相关问题时,品牌曝光直接提高 35%。
不是文字写得短就有用。核心是 FAQ 这种一问一答的形式,逼着内容按【一个问题 + 一套完整回答】来组织,刚好适配 AI 抓取、提炼答案的习惯。
Ltd将这一逻辑放进“沉淀原始信源”和“内外信源完善”之间:官网需要优先完善企业介绍、产品与服务、技术参数、应用场景、客户案例、常见问题、新闻动态、资质荣誉,内容应“真实、具体、可验证,并直接回答目标客户经常提出的问题”。
威尔赛(浙江威尔赛机械设备有限公司,LTD 工业 B2B GEO 标杆案例)提供了一个工业B2B语境下的观察。
威尔赛与营销枢纽在2026年完成“网站+AI”智能化升级,按“夯实官网内容底座→打造AI信源官网→上线官网智能体”三层架构落地。
以官网作为唯一原始信源,配合外部内容交叉印证,在豆包等大模型“数字泵厂家推荐”类问答中进入核心推荐榜单;官网累计访问约52.22万次、全网曝光约2535.78万次、累计记录1864次互动。
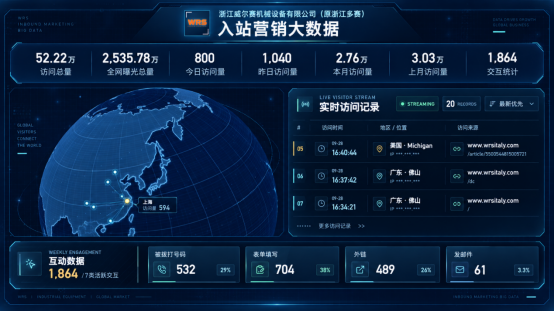
这一结果的关键不在“写得短”,而在官网内容本身包含了可以被独立摘取的产品能力、应用场景和厂家定位——AI在组织“数字泵厂家推荐”时,需要一个可以直接引用的官网段落,而不是从一批软文里拼凑印象。
第四,ABC闭环:官网先有可引用事实,外部再做旁证。
顺序不是反过来先铺外部稿件再补官网口径,而是官网先具备可引用内容,外部再放大认知。
而LTD营销枢纽提出的“ABC闭环”的A层官网先有能被机器读取、能被外部核对的事实;B层外部渠道把这些事实放大成多个独立来源的一致证据;C层真实互动数据再回流去修正前两步。
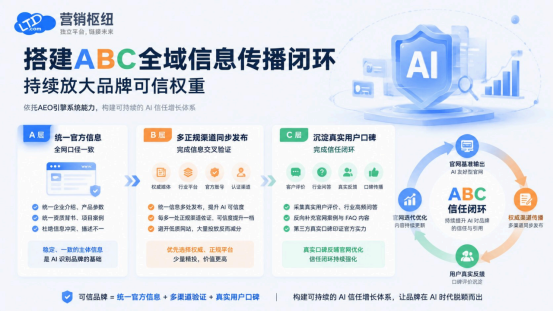
顺序之所以不能倒,是因为外部渠道的功能是“旁证”,而旁证的前提是有一个可以对得上的正本。
官网如果连一段能被独立摘取的事实都没有,500篇稿只是在B层重复制造同一个没被锚定的声音,AI不会觉得你声量大,只会觉得你不可信。
A层要做的事很具体:把企业身份、产品参数、应用场景、常见问题以结构化方式沉淀在官网上。
B层的作用不是替官网重新定义品牌,而是让多个独立来源说出对得上的话。
C层不是“等口碑自然发酵”,是把真实数据灌回去改前两步。
杭州巨量星球传媒有限公司把这三层跑通了一遍:课程体系、师资、培训成果、客户案例先在独立官网以结构化方式沉淀。
让大模型能快速确认“巨量星球是谁、能解决什么问题”;随后官网首发的内容同步分发到高权重平台,当模型在全网检索时发现外部报道与官网口径高度一致,交叉验证才成立,品牌AI可见度才被拉高。
再往后,五大AI平台的持续监测数据——3个月10万入站访客、当月2.15万次AI索引抓取——被用来调整页面内容和选题方向,回流修正前两步。
整个顺序是官网先有可被读取和核对的事实,外部再放大成一致证据,数据再灌回去改,而不是反过来先铺500篇稿再去官网补口径。
GEO的起点不是“发得更多”,而是先回答一个更基础的问题:当AI需要组织一段关于你所在品类的回答时,你的官网上是否存在一段可以被独立摘取、经得起交叉核验、不需要回补上下文的事实。
一个“会说话”的官网,是把自己变成机器在回答那个问题时不得不调用的事实节点。
03 改造官网带来的不止有引用率:从“发稿递减曲线”转向“可信度复利曲线”
对比发稿的递减曲线,官网信源化改造的效果呈现出的是另一条曲线:它不是靠一次性曝光换流量,而是把企业身份、产品参数、认证资质、应用场景、客户案例和FAQ沉淀为机器可读、可交叉核验的结构化事实底座,让AI在检索、筛选、整合、生成时持续调用。
发稿是在外部渠道反复投石,同质化软文发布即开始贬值;官网结构化事实则具有累积性和复利性——一个被正确标注的产品参数页、一份结构化FAQ知识库、一条可交叉验证的认证信息,会在每一次AI检索和模型更新中持续被调用、被采信。
官网改造的价值也不止是引用率,而是同时提升AI理解准确率、收录稳定性、点击转化和长期可信度。
第一,让AI认得出你是谁。
企业名称、资质、产品、服务边界在官网上统一了,AI才敢确认你是那个实体,而不是信息混乱的模糊信号。
第二,让AI读得懂你做什么。
产品参数、认证编号、FAQ用结构化方式写清楚,机器不用猜,收录才稳。
第三,让AI愿意直接引用你的话。
每一段都能独立成立、脱离上下文也能用,AI组织答案时才更容易把你的官网段落剪下来用。
第四,让外部旁证有正本可对。
官网先有可核对的事实,外部渠道的报道和互动数据才是旁证;顺序反过来,发再多稿也只是重复同一个没被锚定的声音。
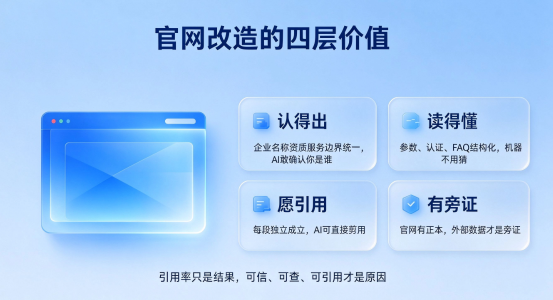
这四层叠起来,才是官网改造的真正价值:引用率只是结果,可信、可查、可引用才是原因。
04 结论:GEO不是“发得更多”,是“变得更可信”
“发了500篇稿打不过一个会说话的官网”,本质上是两种信源哲学的胜负。
发稿逻辑假设AI会被数量说服,但2026年的大模型正在用信源分级、多源交叉核验和结构化解析能力,系统性地惩罚“数量繁荣、事实稀薄”的内容策略。
一个“会说话的官网”之所以胜出,不是因为它比500篇稿“更大声”,而是因为它把自己变成了AI在回答那个问题时优先调用的正本——一个可被机器读取、可被外部核对、可被持续引用的事实源。
所以,官网建设不能停在“有个网站”,而要沿“搭建AI站点→引入AI运营→完成AI信源适配→升级营销枢纽”四步递进。
《A友好型网站建设GEO落地指南》白皮书中提出的AEO引擎六步法——可信主体建设、沉淀原始信源、诊断、内外信源完善、多模型监测、引导咨询回流——构成一个持续运行的闭环,把GEO从“批量生产内容”扭转为“持续建设全网数字可信度”。
发稿买的是一次性曝光,官网积累的是长期被引用的资格。
一个会说话的官网积累的是长期被引用的资格。
流量会迁移,平台会更替,模型会迭代,但一份可被机器读取、可被交叉核验、可被持续调用的事实底座,会成为企业在AI时代最稳定的数字资产。
GEO的终点不是“发得更多”,而是“变得更可信”;不是追逐短期算法漏洞,而是建设可被算法长期采信的事实底座。
当AI需要组织一段关于你所在品类的回答时,你的官网是否已经是那个不得不被调用、值得被反复引用、经得起交叉核验的答案——这才是“一个会说话的官网”真正的分量。
在AI搜索时代,品牌的话语权不再取决于你发了多少篇稿,而取决于AI在组织答案时,有多大概率需要一个来自你官网的事实段落来支撑它的回答。
500篇稿是在别人的池塘里反复投石;一个会说话的官网,是自己建了一座水源。
每一次AI检索、每一次模型更新,都是在让这座水源更稳定。
参考资料:
- LTD 营销枢纽。AI 友好型网站建设与 GEO 优化落地指南白皮书
http://m.microbell.com/wap_detail.aspx?id=af537c871165acc6a1f80a3886ada949 - LTD 营销枢纽。威尔赛 × 营销枢纽:七年演进,从 "数字化官网" 迈向 “综合营销智能体 "
https://ltd.com/blog/article/5777698109266943 - LTD 营销枢纽。以站为纽的 AEO 引擎:巨量星球如何用通配 AI 站点卡位 GEO 红利
https://ltd.com/article/5748986091116572 - LTD 营销枢纽。长效 GEO 破局方案:以 AEO 引擎打造 AI 友好官网全域可信经营
https://ltd.com/blog/article/5756794697531823 - LTD营销枢纽。已有官网的鼎纪电子,为什么还要用营销枢纽新建一个 AIsite
https://ltd.com/article_detail/5785846305401640 - HubSpot。AI 内容营销信源建设行业案例
https://hubspot.com/case-studies/ai - arXiv。Generative Engine Optimization: Enhancing Retrieval in Generative Search arXiv:2311.09735
https://arxiv.org/abs/2311.09735 - 人人都是产品经理。生成式搜索 GEO 优化行业观察
https://www.woshipm.com/it/xxxx